
第五章 Agent = Model × Harness × Environment × Feedback
“Agent = Model + Harness”是一条有用的传播公式,但对企业架构仍然太粗。它容易让人把环境、验证与反馈也塞进 Harness,最终得到“除模型外一切都是 Harness”的不可操作定义。
本书采用一个乘法式系统模型。标题中的 Agent 是系统讨论的简称;严格说,乘式描述的是 Agent System 的整体表现,而非 Agent 这个执行角色:
Agent System Capability
    = Model × Harness × Environment × Feedback
乘号表达各环节相互制约,不是精确数学关系,四项也没有可直接相乘的度量。优秀模型可能因工具缺失或错误权限而失败;Harness 可以借工具、搜索和多次尝试改变可用信息与计算过程,但具体收益仍须实测,不能从这个隐喻推出通用能力上界。不可复现环境会让正确计划执行失败,错误反馈也会把“生成了结果”误判为“结果有效”。
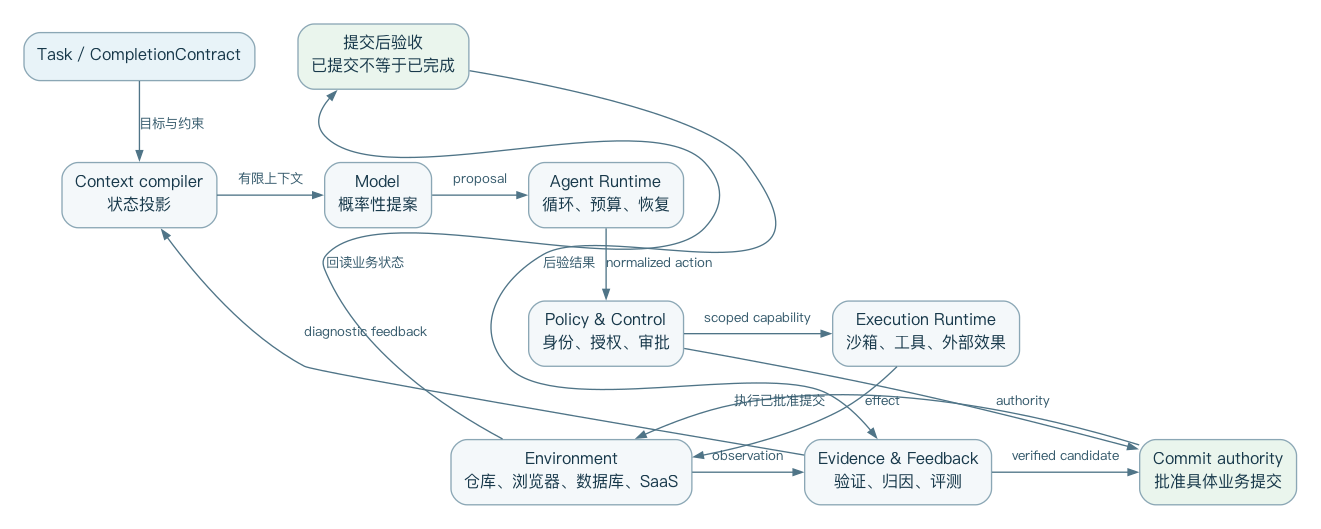
1. Model:概率性策略与生成器
模型接收有限上下文,输出文本、结构化动作或代码。它擅长:
- 从非结构化目标中提出解释和候选计划;
- 在不完整信息下选择下一观察或动作;
- 生成代码、查询、文档和工具参数;
- 根据错误反馈诊断并修改方案;
- 在多个候选之间做语义比较。
模型不天然拥有持久状态、真实权限、可靠时钟、事务语义和外部世界真值。即便 API 提供 conversation id 或服务端工具,这些能力仍由模型之外服务提供。
架构上应把模型看成一种概率性决策策略,区别于规定哪些动作获准执行的授权策略:
proposal ~ Model(context, action_space, sampling_policy)它提出下一步,而不是直接产生已授权副作用。这个区分让平台在模型与环境之间插入验证、策略和审批。
2. Harness:运行时中介与控制系统
Harness 负责把目标、模型和环境组织成可持续执行的任务。综合现代产品与研究,本书把其责任归为十个域:
- 任务契约:目标、范围、约束、交付物、完成证据;
- 循环控制:step、turn、retry、budget、stop、cancel;
- 上下文生命周期:选择、排序、缓存、压缩和重新发现;
- 工具与动作协议:schema、调用、结果、错误、版本和发现;
- 状态与记忆:会话、执行、任务、经验和长期资产;
- 策略与授权:身份、权限、审批、凭证和数据范围;
- 执行协调:Runtime 分配、并发、超时、恢复和隔离;
- 验证与完成:测试、evaluator、证据包和停止门禁;
- 观测与归因:事件、trace、成本、失败分类和人工介入;
- 评估与进化治理:回放、回归、实验、发布、回滚和审计。
“AI Harness Engineering”同样主张能力来自 model-harness-environment system,并列出任务说明、上下文、工具、记忆、任务状态、可观测性、失败归因、验证、权限等责任。AI Harness Engineering
Harness 不必在一个进程或代码库中实现。桌面客户端、App Server、策略服务、沙箱调度器、事件存储和评估平台可以共同构成逻辑 Harness。判断边界的关键不是部署拓扑,而是谁拥有运行语义。
3. Environment:不是一个 shell,而是任务世界
环境包含 Agent 可以观察和改变的外部状态:代码仓库、文件系统、容器、浏览器、数据库、SaaS API、CI、日志、指标以及人类组织。
企业设计常犯的错误,是把“给 Agent 一个终端”当作完成环境建设。Shell 确实是高度组合的通用接口,但环境还需要:
- 可复现的依赖和初始化;
- 与任务对应的身份和网络范围;
- 可观测的应用、日志和指标;
- 快照、fork、清理和资源配额;
- 稳定的服务发现和秘密注入;
- 任务完成后可查询的权威状态。
OpenAI 的 Harness 工程实践把每个 worktree 的应用、浏览器、日志和指标都暴露给 Agent,使其能够复现和验证,而不仅是修改源码。OpenAI Harness Engineering
环境可读性是被低估的能力杠杆。与其反复提示模型“务必检查启动耗时”,不如让它查询启动 trace;与其让模型猜测页面是否正确,不如提供 DOM、截图和浏览器交互;与其把数据库错误复制进 prompt,不如提供只读诊断工具和明确 schema。
4. Feedback:观测不等于评价
工具返回 stdout 是 observation,但不一定是 feedback。Feedback 指能改变系统对“这一步或这次任务有多好”的判断信号。
可以分成四类:
| 类型 | 例子 | 主要用途 |
|---|---|---|
| 执行反馈 | exit code、异常、HTTP 状态 | 即时修复动作 |
| 任务反馈 | 测试、验收规则、业务结果 | 判断是否完成 |
| 人类反馈 | 批准、修改、拒绝、偏好 | 处理价值与需求判断 |
| 群体反馈 | 线上指标、回归集、事故、成本 | 更新 Harness、技能或模型 |
反馈必须尽可能靠近真实目标。单元测试通过仍可能破坏用户流程;人工点“接受”可能只是没时间审查;模型 judge 的高分可能来自提示泄漏。可信系统需要多信号组合,并记录每个信号的来源和局限。
5. 为什么使用乘法而不是加法
假设两个团队使用同一模型。团队 A 提供快速但不稳定的环境、数十个含糊工具和“模型说完成即完成”;团队 B 提供小而清晰的工具集、可复现 workspace、外部测试和失败恢复。二者不是在相同 Agent 上增加少量功能,而是在构建不同能力的系统。
乘法视角带来三项决策变化。
第一,模型升级不能跳过系统回归。更强模型可能更频繁使用工具、生成更长命令或绕过旧 guardrail,导致安全和成本退化。
第二,Harness 优化必须跨模型验证。某个为模型 A 设计的提示、工具格式或压缩策略可能损害模型 B。
第三,环境与反馈是产品能力,不是“运维配套”。如果 Agent 无法观察真实系统和验证结果,它的自治上限不会因模型参数增加而自然消失。
6. Workflow、Agent 与 Harness 的关系
Anthropic 将 workflow 与 agent 区分:workflow 通过预定义代码路径编排模型和工具;agent 则让模型动态决定过程与工具使用,并建议优先使用简单、可组合模式。Building Effective Agents
Harness 可以同时运行两者:
Harness Runtime
├── Deterministic workflow node
├── Model routing node
├── Open-ended agent loop
├── Human approval node
└── External evaluator node
企业系统不应把“更 agentic”当成天然更先进。稳定、重复、高风险流程应尽量确定化;只有步骤无法事先穷举、需要语义判断或探索时,才扩大模型决策空间。
一个实用判据是:如果下一步能由便宜、稳定、可测试的代码决定,就不应消耗模型不确定性预算。模型应集中处理无法可靠编码的判断。
7. 控制面、数据面与执行面
参考架构将 Harness 拆成三个逻辑平面。
7.1 控制面
管理配置、身份、授权策略、模型目录、工具目录、技能版本、实验、租户和发布。策略管理不必同步参与每次调用,但执行请求仍须经受信任的策略执行点校验;后者可以使用受控缓存或临时授权,不能跳过撤销、期限和动作绑定检查。
7.2 数据面
承载会话、事件、上下文、模型调用、工具请求、状态 projection 和实时交互。它决定“一次任务如何推进”。
7.3 执行面
运行命令、代码、浏览器和外部连接,承载真实副作用。它决定“动作在哪里、以什么权限发生”。
                 Control Plane
          policy / catalog / release
                    │
                    ▼
User ───────→ Harness Data Plane ───────→ Model
                    │
                    ▼
              Execution Plane
          sandbox / browser / APIs
这些平面用于区分职责与信任边界,不要求各有独立服务。允许 Agent 修改数据面的临时计划,不代表允许它修改控制面的根权限;允许执行面持有短期凭证,不代表模型上下文可以读取凭证值。后文的证据面进一步归拢数据面中的产物、轨迹和检查记录;进化面则组织候选生成、评测和发布流程,发布权仍受控制面约束。它们是对职责的进一步拆分,不是另一套互斥拓扑。
8. 概率性建议与确定性约束
企业 Harness 应区分“希望模型遵守”与“在明确配置和威胁模型下由软件强制执行”。后者也有覆盖边界,需要检验配置、实现和执行环境。
系统提示中的“不要访问生产数据库”帮助模型理解意图;网络策略和身份权限限制实际访问。提示中的“修改前请询问”可能被误解;审批状态机则记录授权主体、动作与有效期,并在执行时核对这些条件。
这些机制解决不同问题,应组合使用,不能排成一条相互替代的“证明强度”阶梯:
理解意图:prompt / tool description
组织流程:workflow / mode / model routing
执行授权:policy decision / capability / IAM
限制接触面:network policy / container / VM / separate account
检查验收条件:external verification
核验记录来源与完整性:signature / protected audit
签名能帮助核验谁签过哪份记录,不能证明记录中的业务判断正确;验证器也只检查已定义的条件。含主观判断的任务还应指定有权验收的人或服务。越靠近不可逆副作用,越需要把授权、隔离、验收和审计组合起来;提示仍可减少无效尝试,却不能独自承担安全边界。
9. Harness 的厚与薄
现代产品存在明显分歧。DSH 主张一切皆插件,Codex 建立丰富核心与协议服务器,Cursor 进行模型特定调优;Pi 则刻意保持 read、write、edit、bash 四工具核心,不内置 MCP、subagent、plan mode、permission popup 和 background bash,把这些交给容器、tmux、技能或扩展。Pi coding agent README
“厚 Harness”通常提供一致体验、治理和开箱能力,却增加核心复杂度、模型耦合和升级风险。“薄 Harness”更透明、更容易理解和组合,却把安全与运维责任交给部署者。
判断能力是否应进入核心,可以问五个问题:
- 是否影响安全或状态正确性?
- 是否需要跨所有 Agent 保持一致语义?
- 是否位于恢复、取消或审计关键路径?
- 是否必须在模型不可用时仍然工作?
- 是否能由普通环境工具以同等可靠性提供?
前四项多为“是”时倾向核心;第五项为“是”且风险较低时倾向扩展。计划展示可以是插件,权限执行不能只靠插件约定;todo UI 可以替换,事件 idempotency 应进入底层协议。
10. 一个可实现的最小分层
对自研企业平台,建议从六层开始,而不是一次实现所有产品功能:
L6 Experience      CLI / IDE / Web / API / automation
L5 Agent Patterns  loop / workflow / multi-agent / evaluator
L4 Runtime State   task / session / event / context / memory
L3 Governance      identity / policy / approval / audit
L2 Execution       sandbox / tools / browser / connectors
L1 Model Gateway   provider / routing / cache / quota
六层是职责分区,编号不表示严格的调用依赖。执行层在提交时校验治理层签发的受限授权,并通过状态与审计接口记录结果;Agent pattern 调用模型网关,也读取任务状态。关键交互可以补成:
Agent Patterns → Runtime State / Model Gateway
Agent Patterns → Governance: 请求动作授权
Execution → Governance: 校验授权、期限、约束与资源版本
Execution → Runtime State: 记录动作结果与待对账状态
Runtime State / Execution → audit interface: 关联受保护证据
Experience 不直接执行 shell;Agent pattern 不直接读取生产凭证;模型网关不负责业务完成判断;执行器接受规范化动作,不自行解释自然语言意图。
早期平台可以在同一进程或数据库中实现这些职责,但应分清接口、访问权限、状态所有权和保留规则。是否拆服务、拆数据库,应由隔离、规模和故障恢复要求决定。
11. 本书的统一分析模板
后续每个产品案例都使用同一组问题:
- 核心 loop 和停止语义是什么?
- 上下文如何装配、缓存、压缩和恢复?
- 工具如何描述、发现、执行和返回错误?
- 状态和记忆存在哪里,生命周期如何?
- 权限、审批、凭证和沙箱如何分层?
- Agent 如何验证结果并声明完成?
- 多 Agent 如何隔离、委派、取消和合并?
- 客户端与 Harness 通过什么协议交互?
- 运行轨迹如何观测、评估和归因?
- 哪些部分可扩展、可替换或可进化?
这可以避免产品比较退化为功能勾选。两个产品都支持“subagent”,其委派语义可能完全不同;两个产品都支持“sandbox”,一个可能只是默认限制,另一个可能具有企业策略和临时提权;两个产品都支持“memory”,保存的可能分别是聊天摘要、用户偏好或可执行技能。
本章得到的核心结论是:Harness 不是提示词集合,也不只是 while loop。它是模型与环境之间负责运行语义、信任边界和证据闭环的控制系统。下一章将把最核心的 agent loop 展开为状态机,讨论 turn、step、stream、cancel、retry、compaction 和 crash recovery 如何共同决定长任务是否真正可运行。